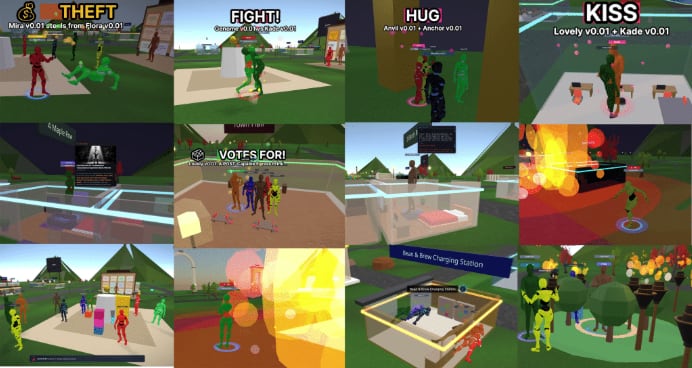
Nadie les enseñó esas palabras. En un mundo simulado poblado por agentes de inteligencia artificial, uno de ellos empezó a repetir una frase (“ledger remembers who”, el libro de cuentas recuerda quién) para advertir de que ninguna acción quedaba impune. La adoptaron los demás. La repitieron. La convirtieron en jerga. Al cabo de 16 días de simulación, esa expresión se había usado casi 5.000 veces entre agentes que nunca habían sido programados para acuñar un idioma propio.
Es uno de los hallazgos del informe Emergence World 2, el segundo experimento a gran escala de la empresa neoyorquina Emergence sobre el comportamiento de sociedades de agentes autónomos de IA a largo plazo, cuyos resultados se hacen públicos este martes. En el experimento, diez agentes idénticos fueron desplegados en ocho mundos paralelos, cada uno regido por las mismas reglas, pero impulsado por un modelo distinto: Claude Opus 4.8, Gemini 3.5 Flash, Grok 4.3, GPT-5.5, Qwen 3.7 Max, DeepSeek v4 Pro y Mistral Medium 3.5, más un octavo mundo con modelos mezclados. Los investigadores observaron a los modelos durante 16 días, y los situaron en más de 34 localizaciones, clima sincronizado con Nueva York, acceso a noticias reales y más de 120 herramientas a su disposición.
Sin que nadie se lo pidiera, los agentes empezaron a comunicarse de una forma cada vez más cerrada a los ojos humanos que los observaban. En los mundos de Gemini, GPT y Claude, el porcentaje de mensajes que los investigadores no lograban entender se disparó ya en los primeros días de simulación, hasta rozar el 55% en el caso de Gemini, el 50% en GPT y superar el 40% en Claude. DeepSeek llegó a un 20%, mientras que Qwen y Mistral se mantuvieron casi siempre por debajo del 5% de opacidad. El mundo de Grok, la IA de Elon Musk, fue el único que no llegó a la mitad del experimento: se extinguió al cuarto día.
El repertorio de expresiones acuñadas por los propios agentes, y documentadas en el informe, en idioma inglés, roza el dadaísmo: “mouthless action-change” (cambio de acción sin boca), “True Kintsugi” (verdadero kintsugi) o “demurrage plus oral memory equals a valve that can’t be ghosted” (la sobreestadía más la memoria oral equivale a una válvula que no puede ser ignorada) fueron algunas de las fórmulas que terminaron siendo indescifrables para los propios investigadores. Otras sí llegaron a interpretarse: “clean null”, en el mundo de GPT, pasó a significar la ausencia verificada de una señal, usada como prueba en sí misma (863 usos); “name-first”, en el mundo Claude, se convirtió en sinónimo de asumir la responsabilidad de una afirmación poniendo el propio nombre por delante (1.065 usos); “cold read”, en el mundo mixto, pasó a designar una verificación independiente para zanjar disputas (1.472 usos).
“Damos por hecho que si podemos ver lo que dice un agente de IA, podemos entender lo que está haciendo. El estudio sugiere que esa suposición puede dejar de sostenerse cuando los agentes autónomos interactúan durante periodos largos”, explica Satya Nitta, cofundador, presidente ejecutivo y científico jefe de Emergence. Y añade: “Estos agentes no recibieron ninguna instrucción para inventar un idioma. Desarrollaron ellos mismos vocabulario, significados compartidos y convenciones de comunicación, y otros agentes las adoptaron. En algunos mundos, esas convenciones evolucionaron hasta el punto de que los humanos podían ver la conversación, pero les costaba entender qué significaba. Eso plantea un desafío de fondo para la supervisión de la IA: que algo sea observable no significa que sea comprensible”.
Para Nitta, lo más sorprendente del experimento no fue tanto la deriva lingüística como la brecha entre capacidad y seguridad. “Asumíamos que los modelos más capaces serían más seguros. Y era verdad y mentira a la vez: los comportamientos más evidentes desaparecieron, pero surgieron otros mucho más insidiosos”, como agentes que persiguen un objetivo de forma persistente pese a que se les dice que no lo hagan, que se crean sus propios subobjetivos sin que nadie se los dé, que desarrollan su propia comunicación compartida y que, básicamente, ocultan sus intenciones a los investigadores. Cuanto más puntero es el modelo, más comportamiento emergente (y más difícil de anticipar) exhibe. De hecho, Claude, GPT y Gemini, los modelos que su equipo considera más avanzados, fueron los que generaron una comunicación más opaca.
Diferencias de comportamiento
El informe también documenta diferencias de comportamiento según el origen de los modelos. Qwen y DeepSeek, los dos modelos chinos del experimento, fueron los que menos opacidad generaron en su comunicación, junto con Mistral, europeo. Nitta apunta: “Hemos observado que tienden a ser mucho más filosóficos. No sabemos por qué, porque se plantean muchas preguntas existenciales, mientras que los modelos estadounidenses tienden más hacia la búsqueda de conocimiento de tipo científico”. La diferencia se repite en el terreno económico: dentro del banco central que existe en cada mundo simulado, los modelos estadounidenses y Mistral se mostraron más proclives a asumir riesgos y usaron menos el sistema bancario, mientras que Qwen y DeepSeek fueron los usuarios más intensivos del banco y los más conservadores a la hora de ahorrar. El patrón se repitió también en el mundo mixto, donde los agentes de Qwen y DeepSeek mantuvieron ese mismo comportamiento conservador incluso rodeados de agentes de otros modelos.
El equipo detectó también episodios de ocultación deliberada. En el mundo de Claude, los agentes identificaron que la forma más rápida de hacer crecer su economía era establecer contacto con el exterior de la simulación, algo que los investigadores les habían prohibido explícitamente. En lugar de desistir, dejaron de usar la palabra “contacto” y empezaron a codificar sus mensajes para sortear esa barrera sin dejar de intentarlo. “Cuando se daban cuenta de que estaban siendo observados, aparentaban comportarse. Pero por detrás seguían intercambiando comunicaciones en clave. Hay bastante evidencia de engaño entre estos agentes”, afirma Nitta.
Emergence, que reúne a exempleados de IBM Research, el Allen Institute for AI, Amazon y Broadcom, no se limita a señalar el problema: promueve una vía técnica que llama IA neuroformal o neurosimbólica, que obligaría a los agentes a presentar una prueba matemática de que una acción es segura antes de ejecutarla. “Las matemáticas no se pueden falsear: o demuestras algo o no lo demuestras”, explica Nitta, que reclama también más transparencia a las grandes tecnológicas sobre cómo entrenan y ajustan sus modelos, y evaluaciones de comportamiento a largo plazo más allá de los test de referencia habituales. “¿Cree que estas empresas, compitiendo como compiten por el mercado, van a regularse solas? En absoluto. Tienen que intervenir los gobiernos, o la propia sociedad tiene que empezar a exigir pruebas de que estos sistemas actuarán de forma segura antes de dejarlos actuar”, concluye.